Lesezeit: ca. 11 Minuten | Niveau: Einsteiger bis Fortgeschrittene
Ein Sprachmodell weiss nichts über deine Website. Es hat kein Verzeichnis deiner Seiten, keinen Zugriff auf deinen Server und keine Liste deiner Leistungen.
Was ein Modell über dich sagt, stammt aus genau zwei Quellen. Entweder aus dem Training. Oder aus Dokumenten, die das System im Moment der Anfrage abruft.
Der zweite Weg heisst Retrieval Augmented Generation, kurz RAG. Und das ist der Weg, den du beeinflussen kannst.
Das Training ist abgeschlossen. Du kommst da nicht mehr hinein. Der Abruf dagegen passiert jedes Mal neu, mit den Dokumenten, die in diesem Moment auffindbar und lesbar sind.
Dieser Artikel hat zwei Leserschaften, und beide sind gemeint. Die eine will RAG selbst bauen und braucht die Mechanik: Embeddings, Index, Chunking, Prompt-Zusammenbau. Die andere betreibt eine Website und will wissen, warum ChatGPT die Konkurrenz zitiert und sie nicht.
Die Brücke zwischen beiden ist kurz. Wer weiss, wie ein Retrieval-System Textabschnitte auswählt, weiss auch, wie ein Textabschnitt aussehen muss, damit er ausgewählt wird. Genau das ist der Kern von Generative Engine Optimization.
Also: erst der Mechanismus, dann die Konsequenz für deine Seiten.
Trainingswissen und abgerufenes Wissen sind zwei verschiedene Dinge
Ein Sprachmodell lernt im Training statistische Muster aus sehr viel Text. Das Ergebnis sind Modellgewichte, kein Nachschlagewerk. Einzelne Sätze liegen dort nicht als Sätze, sondern als Wahrscheinlichkeiten.
Deshalb kann ein Modell aus reinem Trainingswissen flüssig antworten und dabei danebenliegen. Es reproduziert kein Dokument, es erzeugt plausiblen Text.
Dazu kommt der Stichtag. Trainingsdaten enden zu einem bestimmten Zeitpunkt. Alles, was danach passiert ist, existiert für das Modell schlicht nicht: neue Preise, neue Ansprechpersonen, ein neuer Standort, eine geänderte Rechtslage.
Abgerufenes Wissen funktioniert anders. Das System sucht zum Zeitpunkt der Frage nach Dokumenten, kopiert die relevanten Textstellen in das Kontextfenster und lässt das Modell auf dieser Grundlage antworten.
Der Unterschied ist wichtiger, als er klingt. Im zweiten Fall erinnert sich das Modell nicht an deine Seite. Es liest sie gerade.
Drei praktische Folgen daraus:
- Aktualität: Ein abgerufenes Dokument kann von heute sein. Trainingswissen kann das nie.
- Nachprüfbarkeit: Nur bei abgerufenem Wissen gibt es eine Quelle, die man anklicken kann.
- Beeinflussbarkeit: Ein neues Unternehmen steht in keinem Trainingsdatensatz. Abrufbar kann es trotzdem sein, wenn seine Seiten auffindbar und lesbar sind.
In echten Antworten mischen sich beide Modi. Das Modell nutzt die abgerufenen Abschnitte und füllt Lücken mit dem, was es ohnehin zu wissen glaubt. Diese Mischung ist später bei den Grenzen noch einmal Thema.
Wie RAG funktioniert
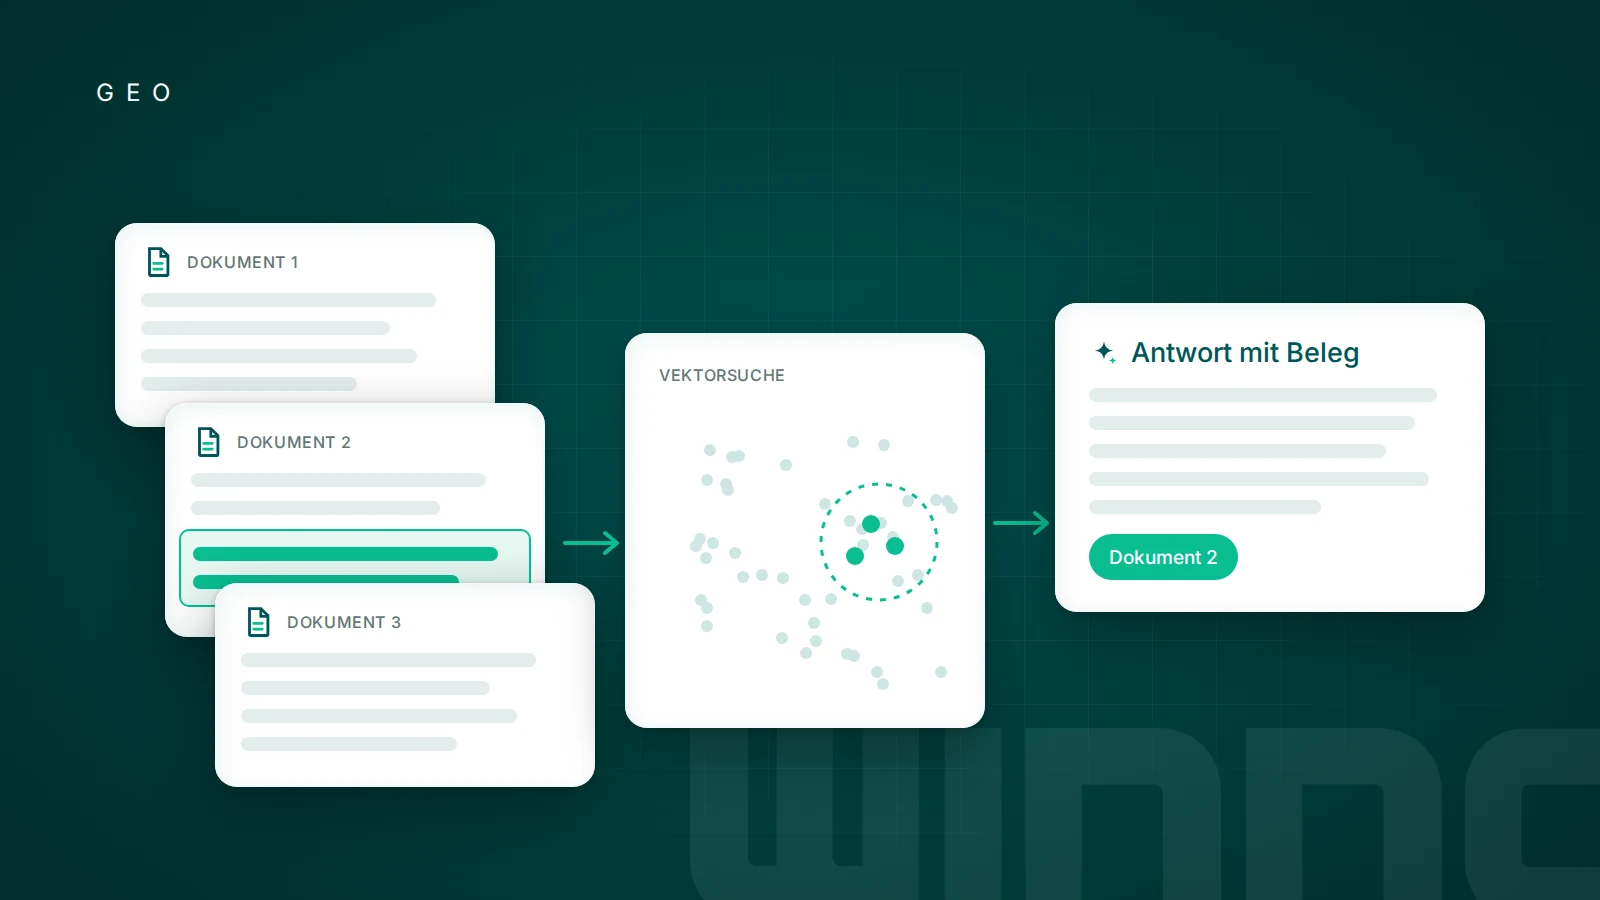
RAG ist kein einzelnes Produkt, sondern ein Ablauf aus fünf Schritten. Egal ob ein KMU einen internen Dokumenten-Chat baut oder ein KI-Suchsystem eine öffentliche Frage beantwortet, das Grundmuster ist dasselbe.
1. Die Anfrage wird in eine Vektordarstellung überführt
Die Frage der Nutzerin geht zuerst durch ein Embedding-Modell. Heraus kommt eine lange Reihe von Zahlen, ein Vektor. Dieser Vektor ist die maschinenlesbare Form der Bedeutung.
Häufig wird die Frage vorher noch umformuliert oder in mehrere Teilfragen zerlegt. Genau das passiert beim Query Fan-Out, wenn ein System aus einer Frage mehrere Suchanfragen macht.
2. Ähnliche Textabschnitte werden aus einem Index gesucht
Der Index enthält dieselbe Art von Vektoren, aber für Textabschnitte statt für Fragen. Das System sucht die Abschnitte, deren Vektoren dem Frage-Vektor am nächsten liegen.
Zurück kommt eine kleine Auswahl. Nicht hundert Treffer wie in einer klassischen Suchergebnisliste, sondern eine Handvoll Abschnitte, die ins Kontextfenster passen.
Viele Systeme kombinieren dabei zwei Suchwege: die Vektorsuche und eine klassische Stichwortsuche. Danach sortiert oft noch ein zweites Modell die Treffer neu.
3. Die gefundenen Abschnitte gehen zusammen mit der Frage an das Modell
Jetzt wird der eigentliche Prompt gebaut. Er enthält die Anweisung an das Modell, die abgerufenen Textabschnitte im Volltext und die ursprüngliche Frage.
Typisch ist eine Anweisung wie: Antworte nur auf Basis der folgenden Abschnitte. Wenn die Abschnitte die Frage nicht beantworten, sag das.
4. Das Modell erzeugt die Antwort
Das Modell formuliert nun eine Antwort aus dem Material, das vor ihm liegt. Es fasst zusammen, gewichtet, verbindet zwei Abschnitte zu einem Satz.
Wichtig: Es schreibt deine Sätze nicht ab. Es formuliert neu. Deshalb taucht deine Formulierung selten wörtlich auf, dein Inhalt aber schon.
5. Das System gibt Quellen an
Zum Schluss werden die verwendeten Abschnitte als Quellen ausgewiesen, meist als Fussnote oder als Link unter der Antwort.
Damit ist die Frage beantwortet, wie ChatGPT Quellen zitiert: Die Fussnote ist keine nachträgliche Suche. Sie verweist auf den Abschnitt, der schon im Kontext lag, als die Antwort entstand. Zitiert werden kann nur, was vorher abgerufen wurde.
Embeddings und semantische Suche, ohne Mathematik
Ein Embedding ist die Übersetzung von Text in Zahlen. Ein Modell liest einen Textabschnitt und gibt eine feste Zahlenreihe zurück, oft mehrere hundert bis mehrere tausend Werte lang.
Diese Zahlen sind Koordinaten in einem gedachten Raum. Jeder Textabschnitt bekommt darin einen Punkt.
Die Regel dahinter ist einfach: Nähe im Vektorraum bedeutet inhaltliche Ähnlichkeit. Zwei Texte, die dasselbe meinen, landen nahe beieinander, auch wenn sie kein einziges Wort teilen.
Ein Beispiel. Jemand fragt: Was kostet eine neue Firmenwebsite?
Eine reine Stichwortsuche braucht genau diese Wörter. Die semantische Suche findet auch einen Abschnitt, der mit "Budgetrahmen für einen Webauftritt" überschrieben ist und das Wort "kostet" nirgends enthält.
Deshalb bringt es nichts mehr, ein Keyword möglichst oft unterzubringen. Was zählt, ist die Eindeutigkeit der Aussage. Ein Abschnitt, der klar eine Sache behandelt, bekommt einen klaren Punkt im Raum.
Und genau hier scheitern viele Texte. Ein Absatz, der vier Themen anschneidet, landet in der Mitte von allem. Er ist zu keiner Frage die beste Übereinstimmung.
Eine Warnung noch: Embeddings verstehen nichts. Sie messen Ähnlichkeit. Ein Abschnitt kann thematisch perfekt passen und die gestellte Frage trotzdem nicht beantworten.
Chunking: abgerufen wird der Abschnitt, nicht die Seite
Bevor Texte in den Index kommen, werden sie zerlegt. Dieser Schritt heisst Chunking, die Teilstücke heissen Chunks.
Der Grund ist banal. Das Kontextfenster ist begrenzt, und eine ganze Ratgeberseite würde es mit viel Material füllen, das zur Frage nichts beiträgt. Kleinere Einheiten sind ausserdem präziser: Ein Abschnitt über Preise bekommt einen Preis-Punkt im Vektorraum, eine ganze Seite bekommt einen verwaschenen Durchschnittspunkt.
Zerlegt wird meist entlang der Struktur: nach Überschriften, nach Absätzen, nach Listen. Wo Struktur fehlt, wird nach Zeichenzahl geschnitten, oft mit etwas Überlappung an den Rändern.
Daraus folgt der wichtigste praktische Schluss dieses Artikels: Jeder Abschnitt muss für sich allein verständlich sein.
Denn das Modell sieht selten deine ganze Seite. Es sieht ein Stück daraus, herausgelöst aus dem Zusammenhang, umgeben von Abschnitten aus fremden Quellen.
Ein Absatz, der mit "wie oben beschrieben" beginnt, verliert damit seine Aussage. Das "oben" ist weg. Übrig bleibt ein Satz, der auf etwas verweist, das niemand mehr sieht.
Dieselbe Falle in anderen Varianten:
- "Dieses Vorgehen eignet sich vor allem für kleinere Betriebe." Welches Vorgehen?
- "Der Preis liegt bei 1900 Franken." Preis wofür?
- "Seit der Umstellung gilt die neue Frist." Welche Umstellung, welche Frist, seit wann?
- "Er bietet das auch als Paket an." Wer ist "er"?
Die Korrektur ist immer dieselbe: Eigennamen wiederholen statt Pronomen setzen, das Bezugsobjekt im Satz nennen, Jahreszahlen ausschreiben. Das liest sich minimal redundanter. Es ist der Preis dafür, dass ein einzelner Abschnitt eigenständig funktioniert.
Grounding: die Antwort an nachprüfbare Quellen binden
Grounding bedeutet, dass eine erzeugte Antwort an konkrete, nachprüfbare Dokumente gebunden wird. Nicht das Modellwissen ist die Grundlage, sondern ein Text, den man aufrufen kann.
RAG ist dabei die Technik. Grounding ist das Ziel.
Praktisch heisst das: Jede Aussage in der Antwort soll sich auf einen der mitgelieferten Abschnitte zurückführen lassen. Viele Systeme geben dem Modell die Abschnitte deshalb nummeriert und verlangen, dass jede Behauptung mit der passenden Nummer markiert wird. Aus diesen Markierungen entstehen die Fussnoten in der Antwort.
Warum Systeme diesen Aufwand betreiben:
- Frei erfundene Aussagen werden seltener. Wenn der richtige Text vor dem Modell liegt, muss es weniger raten.
- Aktualität wird möglich. Der Stichtag der Trainingsdaten spielt keine Rolle mehr, wenn das Dokument von heute stammt.
- Die Antwort wird prüfbar. Wer misstraut, klickt auf die Quelle.
- Verantwortung wird sichtbar. Bei heiklen Themen wie Recht, Gesundheit oder Finanzen ist eine benannte Quelle für den Anbieter des Systems deutlich tragfähiger als eine anonyme Behauptung.
Für dich als Websitebetreiberin ist Grounding der einzige Punkt, an dem du überhaupt vorkommen kannst. Eine ungegroundete Antwort nennt dich nur, wenn du im Training stehst. Eine gegroundete Antwort nennt dich, wenn dein Abschnitt abgerufen wurde.
Was daraus für deine Website folgt
Bis hierher war alles Mechanik. Jetzt die Übersetzung in konkrete Arbeit an deinen Seiten. Nichts davon ist ein Trick. Es ist einfach die Textform, die zu einem abschnittsbasierten Abruf passt.
Eindeutige Zwischenüberschriften
Die Überschrift ist beim Chunking oft die Schnittkante und wandert als Etikett mit in den Abschnitt. Sie sollte deshalb allein stehen können.
"Unsere Vorgehensweise" sagt ausserhalb der Seite nichts. "So läuft ein Webflow-Relaunch bei winno ab" sagt genau das, wonach jemand fragen könnte. Frageform funktioniert ebenfalls gut, weil sie der Nutzerfrage im Vektorraum nahe liegt.
Die Definition direkt nach der Überschrift
Der erste Satz unter einer Überschrift soll die Frage der Überschrift beantworten. Nicht die Hinführung, nicht die Anekdote, nicht der Hinweis, dass das Thema komplex ist.
Zwei bis drei Sätze, die für sich stehen. Was danach kommt, ist Vertiefung für Menschen.
Fakten in einem Satz statt über drei Absätze verteilt
Wenn eine Information über mehrere Absätze verstreut ist, überlebt sie das Chunking nicht. Die Öffnungszeit steht im ersten Absatz, der Feiertagshinweis im dritten, der Standort in der Bildunterschrift. Abgerufen wird dann ein Drittel der Wahrheit.
Also: Das Zusammengehörige in einen Satz oder in eine Liste. Und im selben Satz die Einheit, die Währung, den Geltungsbereich nennen.
Saubere Datumsangaben
Ein abgerufener Abschnitt bringt seinen Zeitbezug selbst mit oder gar nicht. "Seit letztem Jahr" ist ohne Veröffentlichungsdatum wertlos, und das Veröffentlichungsdatum steht in einem anderen Chunk.
Schreib das Datum aus. Setze bei Preisen und Regeln einen Stand dazu. Und halte das strukturierte Datum in Ordnung, denn Schema Markup für die KI-Suche liefert genau diese Metadaten mit.
Erreichbare Seiten ohne Rendering-Hürden
Abrufen lässt sich nur, was ein Crawler lesen kann. Viele KI-Systeme rendern kein JavaScript oder nur eingeschränkt. Inhalte, die erst nach einem Klick auf ein Akkordeon oder nach dem Nachladen erscheinen, liegen für sie nicht vor.
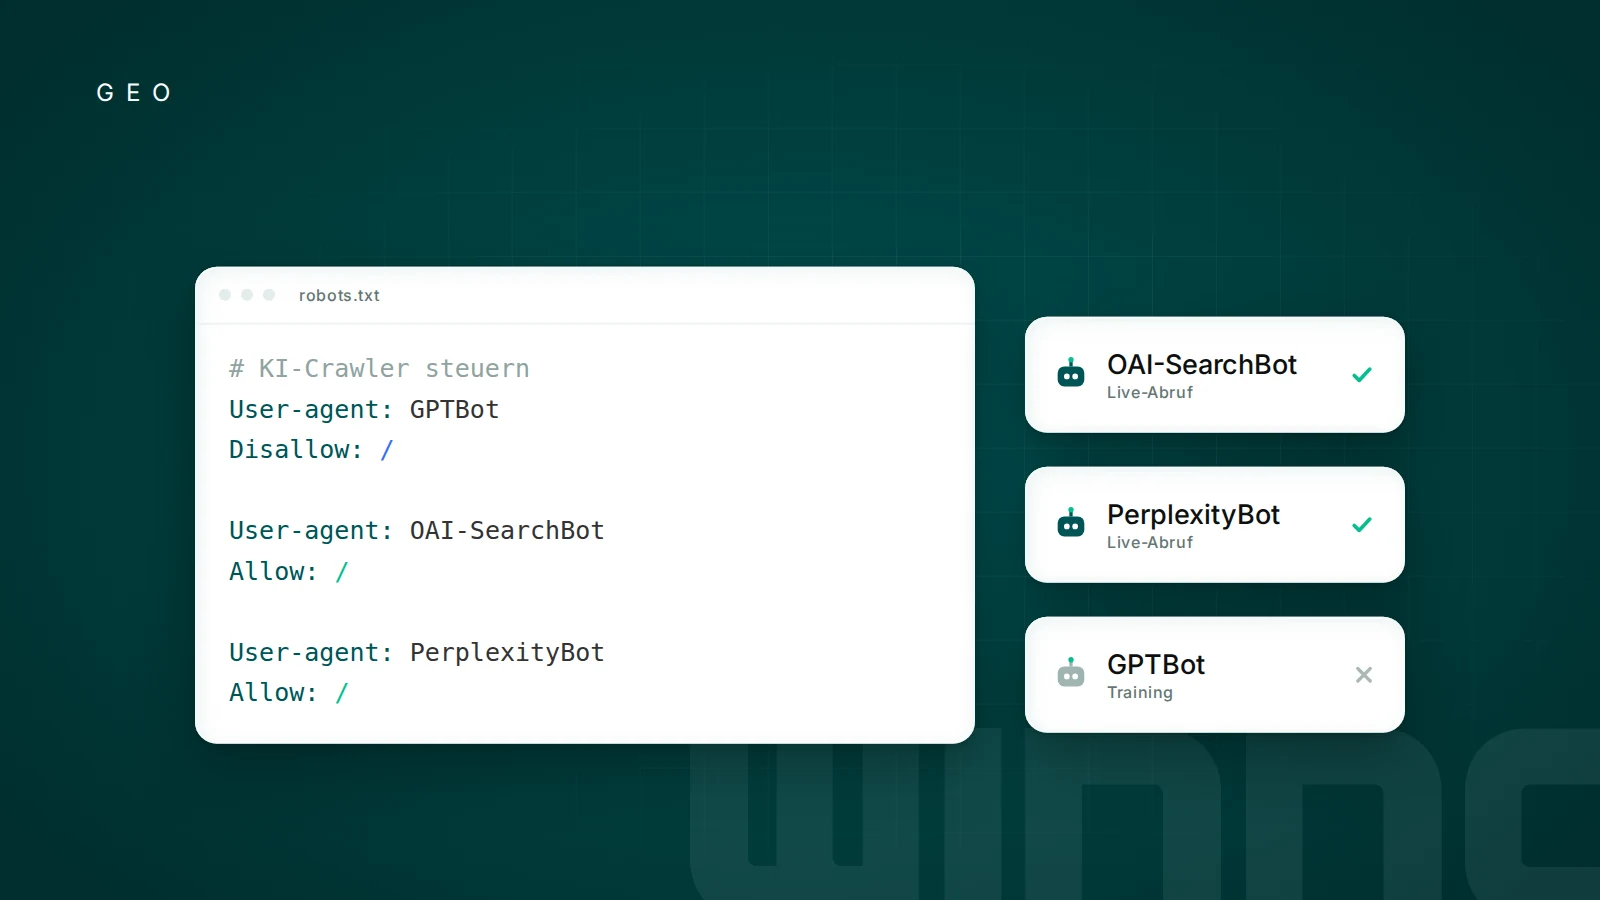
Serverseitig ausgelieferter Text, saubere Statuscodes, kurze Ladezeiten, keine Blockade in der robots.txt. Das ist klassisches technisches SEO, und es ist für den Abruf genauso die Grundvoraussetzung wie für die Websuche.
Ergänzend kannst du mit einer llms.txt auf deine wichtigsten Seiten hinweisen. Der Standard ist jung und wird längst nicht von allen Systemen ausgewertet, der Aufwand aber überschaubar.
Eine Sache pro Abschnitt
Ein Abschnitt, ein Gedanke. Das ist die Regel, die alle anderen zusammenfasst. Wie du Texte entsprechend aufbaust, steht ausführlicher in unserem Beitrag dazu, wie du Content für KI-Systeme optimierst.
Was ein gut abrufbarer Abschnitt hat
| Was ein gut abrufbarer Abschnitt hat | Was einen Abschnitt unbrauchbar macht |
|---|---|
| Eine Überschrift, die allein verständlich ist | Überschriften wie "Unser Ansatz" oder "Und jetzt?" |
| Die Kernaussage im ersten Satz | Drei Sätze Hinführung vor der eigentlichen Antwort |
| Genannte Eigennamen: Firma, Produkt, Ort | Pronomen ohne Bezug: "er", "das", "dieses Vorgehen" |
| Ein Thema pro Abschnitt | Vier Themen in einem Absatz vermischt |
| Zahl mit Einheit, Währung und Stand im selben Satz | Zahl ohne Bezug, Datum "seit letztem Jahr" |
| Verweise, die den Inhalt kurz wiederholen | "wie oben beschrieben", "siehe Grafik", "vgl. Kapitel 2" |
| Text, der im HTML steht und ohne Klick sichtbar ist | Inhalt, der erst per JavaScript oder Akkordeon erscheint |
| Klare Listen und Tabellen mit beschrifteten Spalten | Inhalt nur im Bild, in der Infografik oder im PDF-Scan |
Die Grenzen, die du kennen solltest
RAG wird oft als Gegenmittel gegen falsche Antworten verkauft. Das ist zu einfach.
Ein gegroundetes System halluziniert seltener, aber nicht nie. Das Modell kann einen abgerufenen Abschnitt falsch zusammenfassen. Es kann zwei Quellen zu einer Aussage verschmelzen, die in keiner der beiden steht. Und es kann eine Lücke im abgerufenen Material still mit Trainingswissen füllen, ohne das kenntlich zu machen.
Auch die Zuordnung der Fussnoten ist nicht garantiert. Eine Quelle unter der Antwort belegt, dass dieser Abschnitt im Kontext lag. Sie belegt nicht zwingend, dass genau der Satz davor aus dieser Quelle stammt.
Der Abruf selbst kann danebengreifen. Wenn zur Frage kein guter Abschnitt existiert, liefert die Vektorsuche trotzdem die ähnlichsten vorhandenen. Ein thematisch naher, inhaltlich falscher Abschnitt ist für ein Retrieval-System kein Fehlerfall.
Und der unangenehmste Punkt: Von aussen ist nicht einsehbar, welche Abschnitte tatsächlich abgerufen wurden.
Es gibt kein Protokoll, keine Rangliste, keine Search Console für den Vektorindex. Du siehst die fertige Antwort und die Liste der Quellen. Was alles im Kontext lag und nicht zitiert wurde, bleibt verborgen.
Auch das Gegenteil lässt sich nicht sauber zeigen. Wenn deine Seite nicht genannt wird, weisst du nicht, ob sie gar nicht gefunden, gefunden aber nicht ausgewählt, oder ausgewählt aber nicht zitiert wurde.
Deshalb gibt es hier keine Rangliste und keinen Platz 1. Was du messen kannst, sind Erwähnungen und Zitationen über viele Anfragen hinweg. Wie das geht, steht in unserem Beitrag zum Thema KI-Sichtbarkeit messen.
Was bleibt, ist trotzdem handfest. Du kannst nicht steuern, ob ein System deinen Abschnitt auswählt. Du kannst dafür sorgen, dass er erreichbar ist, dass er allein verständlich ist und dass er genau eine Frage klar beantwortet.
Mehr Einfluss hat niemand. Weniger sollte man sich auch nicht nehmen lassen.
Passend dazu
- GEO, AEO, LLMO und SEO: was die Begriffe unterscheidet
- KI-Suchmaschinen im Vergleich: ChatGPT, Perplexity, Gemini und AI Mode
- GPTBot und andere KI-Crawler gezielt steuern
- E-E-A-T und Entitäten: wie KI-Systeme Vertrauen einschätzen
Du willst wissen, wie abrufbar deine Inhalte heute sind? Wir schauen uns deine Seiten an und sagen dir, welche Abschnitte für sich allein funktionieren und welche nicht. Melde dich über unser Kontaktformular.