Lesezeit: ca. 11 Minuten | Niveau: Einsteiger bis Fortgeschrittene
Eine Maschine liest deine Seite anders als du. Sie sieht keine Visitenkarte, keine Preisliste, keinen Ansprechpartner. Sie sieht Text und muss raten, was davon was ist.
Schema Markup ist der Versuch, dieses Raten zu beenden. Du sagst der Maschine in einer eigenen, festgelegten Sprache: Das hier ist eine Firma. Das ist ihre Adresse. Das ist der Preis. Das ist das Datum der letzten Änderung.
Strukturierte Daten nach schema.org gibt es seit über einem Jahrzehnt. Bekannt wurden sie durch Rich Snippets: Sterne in den Suchergebnissen, Preise unter dem Titel, aufklappbare Fragen.
Für KI-Systeme sind sie aus einem anderen Grund nützlich. Es geht nicht mehr um eine hübschere Darstellung. Es geht darum, dass ein System, das deinen Text zusammenfasst, die Fakten richtig zuordnet.
Dieser Artikel zeigt, wie das technisch funktioniert, welche Typen sich für welche Seite lohnen und wo der Nutzen aufhört. Auch Letzteres, denn hier wird derzeit viel versprochen.
Wie strukturierte Daten funktionieren
Drei Bausteine, dann hast du das Prinzip.
Das Format: JSON-LD im Kopf der Seite
Es gibt mehrere Schreibweisen für strukturierte Daten. Durchgesetzt hat sich JSON-LD, und Google empfiehlt dieses Format in seiner Dokumentation ausdrücklich.
Der Vorteil ist praktischer Natur. JSON-LD steht als eigener Block im head der Seite, sauber getrennt vom sichtbaren HTML. Du musst also nicht deine Textauszeichnung umbauen, um Daten zu ergänzen. Du legst einen Block daneben.
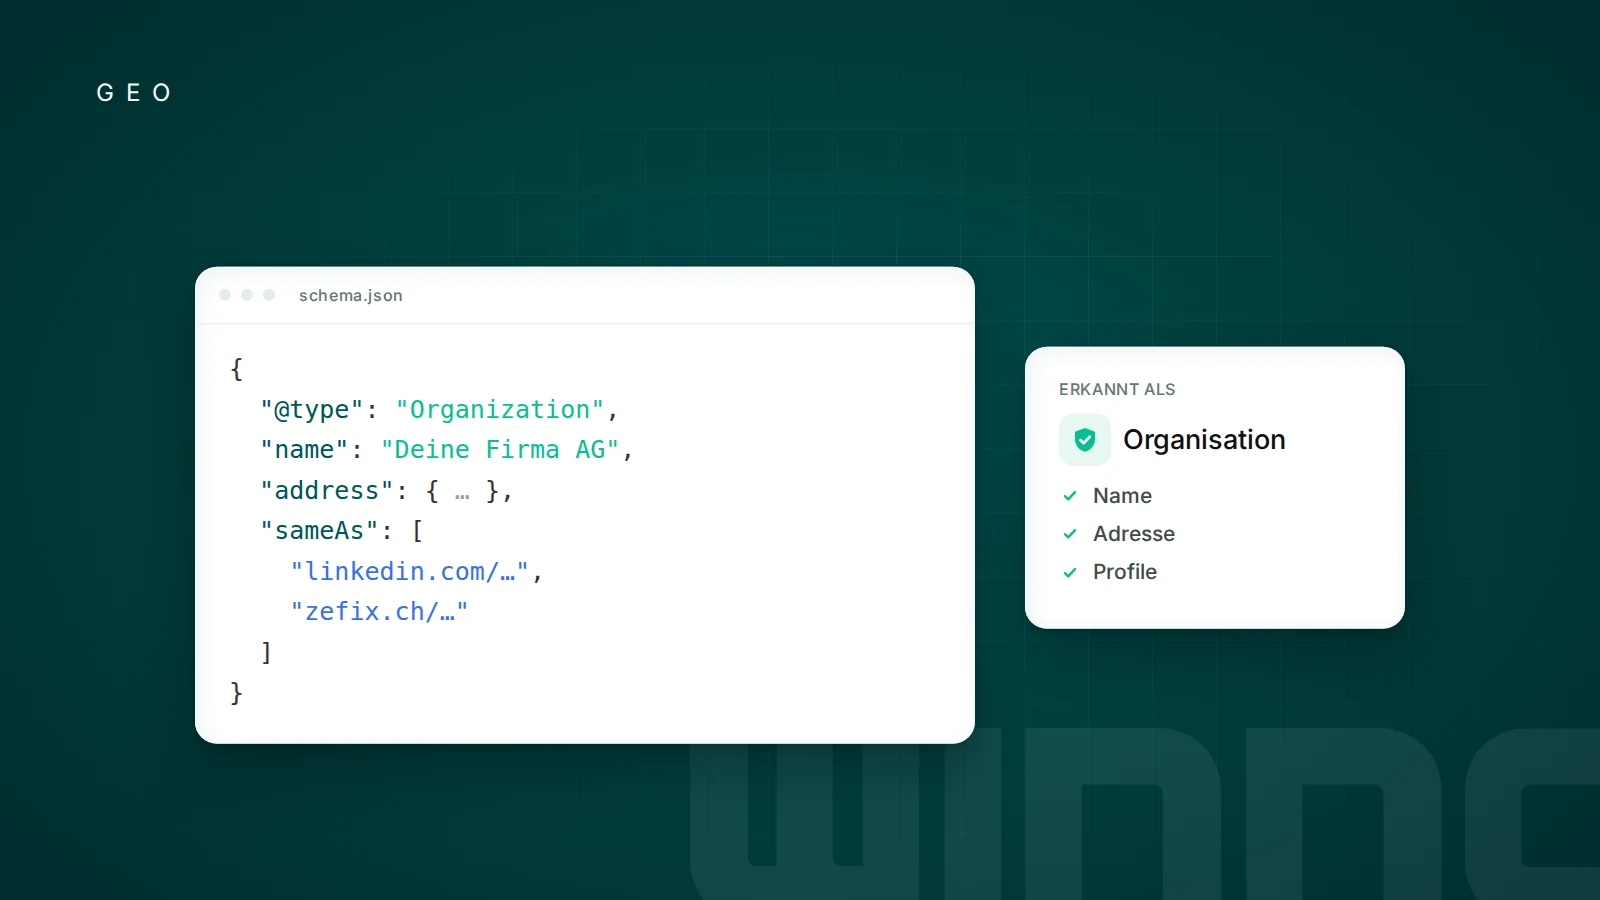
Der Block ist schlicht aufgebaut. Er beginnt mit einem Verweis auf das Vokabular und nennt dann den Typ und dessen Eigenschaften. In Worten liest sich das so: Kontext ist schema.org, Typ ist Organization, Name ist Muster AG, Telefon ist die und die Nummer.
Menschen sehen von alldem nichts. Maschinen lesen es zuerst.
Das Vokabular: Typen und Eigenschaften
schema.org ist ein gemeinsames Vokabular, das von Google, Microsoft, Yahoo und Yandex getragen wird. Es besteht aus Typen und Eigenschaften.
Ein Typ ist eine Sorte Ding: Organization, Person, Product, Article, LocalBusiness, Event, Recipe. Eine Eigenschaft ist ein Merkmal dieses Dings: name, address, telephone, author, datePublished, price.
Die Typen stehen in einer Hierarchie. LocalBusiness ist eine Unterart von Organization, und alles, was eine Organization kann, kann auch ein LocalBusiness. Deshalb wählst du immer den spezifischsten Typ, der noch stimmt. Er erbt die allgemeineren Eigenschaften mit.
Eigenschaften können selbst wieder Objekte enthalten. Eine Adresse ist kein Textfeld, sondern ein eigenes Ding vom Typ PostalAddress mit Strasse, Postleitzahl, Ort und Land. Dadurch entstehen verschachtelte Angaben statt langer Zeichenketten, die jemand wieder auseinandernehmen muss.
Die Idee dahinter: die Entität hinter der Seite
Jetzt der entscheidende Gedankensprung. Eine Seite und das Ding, um das es auf ihr geht, sind zwei verschiedene Sachen.
Deine Startseite ist ein Dokument. Deine Firma ist ein Unternehmen mit Adresse, Gründungsjahr und Mitarbeitenden. Das Dokument beschreibt das Unternehmen, ist aber nicht das Unternehmen.
Genau diese Trennung drückt Schema aus. Du beschreibst nicht die Seite, du beschreibst die Entität, um die es auf der Seite geht. Ein Ding mit Eigenschaften und Verbindungen zu anderen Dingen.
Damit die Verbindungen halten, bekommt jede Entität eine eigene Kennung, die @id. Meist ist das eine URL mit einem Anker, etwa die Startseite mit dem Zusatz Raute Organisation. Auf dieselbe Kennung verweist du dann von jeder anderen Seite aus.
Das Ergebnis ist kein Stapel unverbundener Schnipsel, sondern ein kleines Netz: eine Firma, dazu ihre Leistungen, ihre Standorte, ihre Artikel und die Menschen, die sie geschrieben haben.
Welche Typen sich für welche Seite lohnen
Nicht jede Seite braucht Schema, und mehr Typen sind nicht besser. Die folgende Zuordnung deckt ab, was bei den meisten Websites tatsächlich vorkommt.
| Seitentyp | Schema-Typ | Was er ausdrückt | Priorität |
|---|---|---|---|
| Startseite | Organization, bei lokalem Geschäft LocalBusiness | Wer die Firma ist: Name, Logo, Adresse, Kontaktpunkt und Profile anderswo im Netz. | Hoch |
| Leistungsseite | Service, verknüpft mit der Organisation als Anbieter | Welche Leistung angeboten wird, von wem und für welches Gebiet. | Mittel |
| Blogartikel | Article oder BlogPosting | Titel, Autor, Veröffentlichungsdatum, letzte Änderung und Herausgeber. | Hoch |
| FAQ-Bereich | FAQPage | Frage-Antwort-Paare, die genau so auch sichtbar auf der Seite stehen. | Mittel |
| Über uns | AboutPage, dazu Person je Kopf | Wer hinter der Firma steht, mit Rolle und Zugehörigkeit. | Mittel |
| Standortseite | LocalBusiness | Adresse, Öffnungszeiten, Telefonnummer, Einzugsgebiet, Koordinaten. | Hoch bei lokalem Geschäft |
| Produktseite | Product mit eingebettetem Offer | Artikel, Preis, Währung, Verfügbarkeit und Zustand. | Hoch im Shop |
| Bewertungen | Review und AggregateRating | Einzelurteile und der Durchschnitt daraus. | Tief bis mittel |
Zwei Zeilen brauchen eine Erklärung, weil dort häufig Zeit verbrannt wird.
FAQPage steht auf Mittel, obwohl es lange als sichere Bank galt. Google hat die Anzeige von FAQ-Ergebnissen in der Suche stark eingeschränkt und beschränkt sie laut eigener Dokumentation auf wenige Arten von Websites. Die Auszeichnung bleibt gültig und maschinenlesbar. Als Weg zu einem auffälligeren Suchergebnis taugt sie kaum noch.
Review und AggregateRating stehen tief, weil Google Bewertungen, die eine Firma über sich selbst auf der eigenen Seite auszeichnet, für Rich Results ausschliesst. Sternchen aus dem eigenen Haus erscheinen nicht. Echte Bewertungen bei Dritten wirken hier stärker als jede Auszeichnung im eigenen Quelltext.
Wenn du priorisieren musst, ist die Reihenfolge einfach. Zuerst Organization auf der Startseite, dann Article auf den Blogartikeln, dann LocalBusiness auf den Standortseiten. Alles Weitere ist Feinarbeit.
Organization: das Fundament
Wenn du nur eine einzige Auszeichnung umsetzt, dann diese. Sie beantwortet die Frage, die jedes System zuerst stellt: Wer ist das hier eigentlich?
Diese Eigenschaften gehören hinein.
- name – der Firmenname, exakt so wie im Handelsregister und im Logo. Keine Zusätze, keine Slogans, kein Ortsname als Anhängsel.
- url – die kanonische Adresse der Startseite, inklusive https und der Schreibweise mit oder ohne www, die du auch sonst verwendest.
- logo – die absolute URL zur Bilddatei, nicht der Dateiname allein.
- address – als PostalAddress mit Strasse, Postleitzahl, Ort und Landeskennung CH.
- contactPoint – Telefonnummer im internationalen Format, dazu die Art des Kontakts, etwa Kundendienst, und die Sprachen.
- sameAs – eine Liste von Adressen, unter denen dieselbe Firma anderswo im Netz auftritt.
sameAs: das Bindeglied nach draussen
Von allen Eigenschaften ist sameAs die am meisten unterschätzte. Sie verdient einen eigenen Abschnitt.
Das Vokabular von schema.org beschreibt sameAs als Verweis auf eine Seite, die die Identität des Dings eindeutig bezeichnet. Übersetzt heisst das: Diese Firma dort draussen bin ich.
Warum das zählt, wird klar, wenn du die Lage aus Sicht eines Systems betrachtest. Es findet deine Website. Es findet ein LinkedIn-Profil mit ähnlichem Namen. Es findet einen Eintrag in einem Branchenverzeichnis, einen Google-Unternehmenseintrag und vielleicht einen Wikidata-Datensatz.
Sind das fünf Firmen oder eine? Ohne Hinweis muss das System raten, meist anhand von Namensähnlichkeit und Adresse. Bei häufigen Firmennamen geht dieses Raten oft schief.
sameAs beendet das Raten. Du listest die Profile auf, und die Fundstücke lassen sich zu einer Identität zusammenlegen. Erst dann zählen Erwähnungen an anderer Stelle auf dein Konto ein.
Sinnvolle Einträge sind LinkedIn, Instagram, YouTube, Facebook, X, der Eintrag im Handelsregister, Branchen- und Verbandsverzeichnisse, Wikidata und Wikipedia, falls vorhanden.
Zwei Regeln dazu. Erstens: nur Profile, die dir wirklich gehören und die gepflegt sind. Ein verwaistes Profil von 2019 hilft niemandem. Zweitens: identische Angaben überall. Wenn der Name auf LinkedIn anders geschrieben ist als im Schema, arbeitet die Verknüpfung gegen dich.
Damit ist sameAs die technische Seite eines grösseren Themas. Wie aus einer Firma eine erkennbare Entität wird und was das mit Vertrauen zu tun hat, behandeln wir im Beitrag zu E-E-A-T und Entitäten.
Was Schema für KI-Systeme leistet und was nicht
Jetzt der Abschnitt, der in den meisten Beiträgen zu diesem Thema fehlt.
Beginnen wir mit dem, was nicht belegt ist. Kein Anbieter eines KI-Systems hat bestätigt, dass strukturierte Daten die Auswahl als Quelle beeinflussen. Weder OpenAI noch Google noch Perplexity oder Anthropic dokumentieren einen solchen Zusammenhang.
Wer dir erzählt, Schema Markup bringe dich in KI-Antworten, behauptet mehr, als sich derzeit belegen lässt. Solche Sätze sind in diesem Themenfeld häufig, und meistens steht keine Quelle daneben.
Was strukturierte Daten nachweislich tun, ist zweierlei.
Sie lösen Mehrdeutigkeit auf. Steht auf deiner Seite die Zahl 1250, ist das ein Preis, eine Hausnummer, eine Jahreszahl oder eine Stückzahl? Im Fliesstext muss ein System das aus dem Zusammenhang erschliessen. Im Schema steht es dabei. Aus einer Vermutung wird eine Angabe.
Und sie stellen Fakten maschinenlesbar bereit. Öffnungszeiten, Adresse, Autor, Datum, Preis: Diese Angaben stehen dann an einer festen Stelle in einer festen Form. Sie müssen nicht aus einer Grafik, einer Tabelle oder einem Nebensatz gefischt werden.
Der Nutzen liegt also in der Eindeutigkeit, nicht in einem Ranking-Bonus.
Wichtig ist dabei ein technischer Punkt: Ein System, das deine Seite live abruft, verarbeitet in der Regel den Quelltext und findet den JSON-LD-Block dort vor. Wie dieses Abrufen und Verarbeiten abläuft, beschreiben wir im Beitrag zu RAG und Grounding.
Dazu kommt ein indirekter Weg, der oft übersehen wird. AI Overviews und der AI Mode greifen auf den Google-Index zu. Was dort sauber erfasst ist, steht diesen Antworten zur Verfügung. Strukturierte Daten helfen der klassischen Suche beim Erfassen, und dieser Weg führt weiter.
Ehrliches Fazit: Schema ist eine Grundlage, kein Hebel. Es sorgt dafür, dass die Fakten über dich stimmen, wenn sie gebraucht werden. Es sorgt nicht dafür, dass sie gebraucht werden. Diese Unterscheidung ziehen wir auch im Beitrag zur Generative Engine Optimization durch.
Konsistenz schlägt Vollständigkeit
Es gibt eine Art, Schema einzusetzen, die schlechter ist als gar kein Schema: die widersprüchliche.
Die Regel ist einfach. Was im Schema steht, muss dem entsprechen, was sichtbar auf der Seite steht. Google formuliert das in seinen Richtlinien so, dass strukturierte Daten den Inhalt der Seite wiedergeben müssen und nicht Angaben enthalten dürfen, die dort nicht zu sehen sind.
Typische Widersprüche aus der Praxis:
- Im Schema stehen Öffnungszeiten bis 18 Uhr, im Footer bis 17 Uhr.
- Das Schema nennt eine alte Adresse, weil es beim Umzug niemand angefasst hat.
- Der Preis im Schema stammt aus der letzten Saison.
- Der Firmenname steht im Schema mit AG, auf der Seite ohne.
- Eine FAQPage listet Fragen, die auf der Seite gar nicht vorkommen.
Jeder dieser Fälle erzeugt zwei einander widersprechende Aussagen über dieselbe Firma. Ein System muss sich dann entscheiden, und die Entscheidung fällt nicht zwingend zu deinen Gunsten aus. Im ungünstigen Fall wird die widersprüchliche Angabe gar nicht verwendet.
Am sichtbarsten wird das bei lokalen Angaben. Name, Adresse und Telefonnummer stehen bei den meisten Betrieben an einem Dutzend Stellen: auf der Website, im Schema, im Google-Unternehmensprofil, in Verzeichnissen. Weichen sie voneinander ab, zerfällt die Identität in mehrere Halb-Identitäten. Wie du diese Angaben sauber hältst, steht im Beitrag zum Local SEO.
Praktischer Schluss daraus: Lieber wenige Eigenschaften, die stimmen, als viele, die niemand pflegt.
Prüfen und pflegen
Schema schreibt man nicht blind. Es gibt zwei offizielle Werkzeuge, und beide sind kostenlos.
Der Rich Results Test von Google prüft, ob eine Seite für eine der von Google unterstützten Darstellungen in Frage kommt, und zeigt Fehler und Warnungen dazu. Er beurteilt nur, was Google selbst auswertet.
Der Schema Markup Validator auf schema.org prüft die Auszeichnung gegen das Vokabular, unabhängig davon, was ein einzelner Anbieter davon nutzt. Er ist der ehrlichere Test, wenn du wissen willst, ob deine Struktur an sich korrekt ist.
Dazu kommt die Google Search Console. Dort erscheinen Berichte zu erkannten strukturierten Daten mitsamt Fehlern. Der Unterschied zu den Testwerkzeugen ist wichtig: Die Tests prüfen eine Seite auf Zuruf, die Search Console zeigt, was über die ganze Website hinweg tatsächlich erfasst wurde.
Der Unterschied zwischen Fehler und Warnung wird oft falsch verstanden. Ein Fehler bedeutet, dass eine erforderliche Eigenschaft fehlt. Eine Warnung bedeutet, dass eine empfohlene Eigenschaft fehlt. Fehler behebst du, Warnungen priorisierst du.
Und dann die Pflege, der unspektakuläre Teil. Trägst du eine neue Telefonnummer ein, muss sie auch ins Schema. Beim nächsten Relaunch prüfst du, ob die Blöcke überhaupt noch ausgeliefert werden. Ein Termin im Kalender, einmal im Quartal, reicht für die meisten Websites. Weitere technische Prüfpunkte haben wir im Beitrag zum technischen SEO gesammelt.
Umsetzung in Webflow
Webflow hat kein eigenes Feld für strukturierte Daten. Du arbeitest mit eigenem Code, und das geht an drei Stellen.
- Website-weit. In den Site settings unter Custom code trägst du den Block ins head-Feld ein. Passend für Organization, das auf jeder Seite gelten soll.
- Pro Seite. In den Page settings hat jede Seite ein eigenes head-Feld. Passend für Service, LocalBusiness oder AboutPage.
- Pro CMS-Eintrag. Auf der Vorlage einer Collection-Seite kannst du im head-Bereich Felder aus der Collection einsetzen. Damit erzeugt jeder Blogartikel sein eigenes Article-Schema mit Titel, Datum und Autor, ohne dass du es einzeln pflegst.
Die dritte Variante ist die eigentliche Stärke. Einmal eingerichtet, bekommt jeder neue Beitrag die Auszeichnung automatisch. Achte dabei auf das Datumsformat: Schema erwartet Datumsangaben nach ISO 8601, also Jahr, Monat, Tag.
Zwei Stolperstellen sehen wir in Projekten regelmässig. Eigener Code wird beim Veröffentlichen übernommen, nicht beim Speichern im Designer. Prüfe also immer die veröffentlichte Seite. Und Felder aus dem CMS können Anführungszeichen oder Zeilenumbrüche enthalten, die den Block zerstören. Halte die verwendeten Felder kurz und einfach.
Was in Webflow sonst noch technisch einzurichten ist, steht im Webflow SEO Guide. Wenn du die Einrichtung abgeben willst, übernimmt das unsere Webflow Agentur.
In drei Sätzen
Schema Markup macht die Fakten über dich eindeutig, statt sie einer Maschine zum Raten zu überlassen.
Es ist keine Abkürzung in KI-Antworten, und niemand sollte dir das versprechen.
Aber es ist die Grundlage dafür, dass die Angaben stimmen, wenn jemand sie braucht. Fang mit Organization und sameAs an, alles Weitere baut darauf auf.
Passend dazu
- E-E-A-T und Entitäten: wie Vertrauen entsteht
- Generative Engine Optimization: was dahintersteckt
- Local SEO: lokal gefunden werden
- Technisches SEO: die Grundlagen
Du willst wissen, welche strukturierten Daten deine Website heute ausliefert und wo sie sich widersprechen? Wir schauen es uns an. Schreib uns über das Kontaktformular.