Lesezeit: ca. 9 Minuten | Niveau: Fortgeschrittene
Es gibt nicht den einen KI-Crawler. Es gibt ein gutes Dutzend, und sie tun verschiedene Dinge.
GPTBot ist der bekannteste Name davon, und genau deshalb wird er am häufigsten falsch eingesetzt. In vielen robots.txt-Dateien steht eine Sperre für GPTBot, und der Betreiber glaubt, damit sei das Thema KI erledigt. Ist es nicht.
Denn hinter den User-Agents der Anbieter stehen unterschiedliche Zwecke. Einer sammelt Material für das Training eines Modells. Ein anderer holt deine Seite in der Sekunde, in der jemand eine Frage stellt. Ein dritter baut einen Suchindex.
Wer diese drei Dinge in einen Topf wirft, trifft die falsche Entscheidung. Meistens die teure Variante: Man sperrt sich selbst aus den Antworten aus, in denen man gerne stünde, und liefert das Trainingsmaterial trotzdem weiter, weil andere Seiten zitieren.
Dieser Artikel sortiert das. Er zeigt, welcher Zugriff was bedeutet, wie du ihn in der robots.txt sauber steuerst und wo diese Datei aufhört zu wirken.
Drei Arten von Zugriff, die oft verwechselt werden
Ein Crawler ist ein Programm, das eine URL abruft. Was danach mit dem Inhalt passiert, sieht man dem Abruf nicht an. Die Anbieter trennen diese Zwecke aber selbst, und sie geben jedem Zweck einen eigenen User-Agent-Namen. Das ist der Hebel.
Erstens: Sammeln für das Modelltraining
Hier wird Text eingesammelt und in den Datenbestand gelegt, aus dem ein Sprachmodell lernt. Das passiert lange vor jeder Nutzerfrage, oft Monate davor.
Der Effekt ist träge und anonym. Dein Text färbt auf das allgemeine Sprachwissen des Modells ab. Ein Link zurück auf dich entsteht dabei nicht. Typische Vertreter sind GPTBot und ClaudeBot.
Wenn du diesen Zugriff sperrst, verlierst du keine Sichtbarkeit in aktuellen Antworten. Du verlierst nur die Chance, dass Formulierungen von dir irgendwann Teil des Modellwissens werden.
Zweitens: Abrufen im Moment der Frage
Stellt jemand eine Frage, deren Antwort aktuelle Informationen braucht, löst das System eine Suche aus und holt einzelne Seiten live. Der Text wird gelesen, zusammengefasst und im Regelfall mit einem Link versehen.
Das ist der Zugriff, an dem deine Sichtbarkeit hängt. Er trägt Namen wie ChatGPT-User. Wie dieses Nachladen technisch abläuft, beschreiben wir im Beitrag zu RAG und Grounding.
Sperrst du ihn, kann das System deine Seite im Gespräch nicht öffnen. Es nimmt dann eine andere.
Drittens: Indexieren für eine Suchfunktion
Zwischen den ersten beiden liegt der Suchindex. Er wird vorab aufgebaut und entscheidet, welche Seiten im Moment der Frage überhaupt zur Auswahl stehen. Googlebot macht das für Google, Bingbot für Bing, OAI-SearchBot für die Suche in ChatGPT, PerplexityBot für Perplexity.
Diese Crawler sind die stillen Türsteher. Sie liefern selbst keine Antwort. Aber ohne sie stehst du im Moment der Frage gar nicht zur Auswahl.
Daraus folgen zwei Sätze, die den Kern dieses Artikels bilden.
Wer das Training sperrt, kann trotzdem in Live-Antworten erscheinen. Die beiden Zugriffe sind getrennt steuerbar, und die Anbieter halten diese Trennung in ihrer Dokumentation ausdrücklich fest.
Wer pauschal alles sperrt, schliesst sich selbst aus. Eine Zeile zu viel in der robots.txt, und deine Seiten stehen genau den Systemen nicht mehr zur Verfügung, die sie zitieren würden.
Die bekannten User-Agents im Überblick
Die folgende Tabelle listet nur Funktionen, die der jeweilige Anbieter selbst dokumentiert. Namen und Zwecke ändern sich, neue Agenten kommen dazu. Prüfe die Dokumentation des Anbieters, bevor du eine Sperre setzt.
| User-Agent | Anbieter | Wozu der Zugriff dient | Empfehlung |
|---|---|---|---|
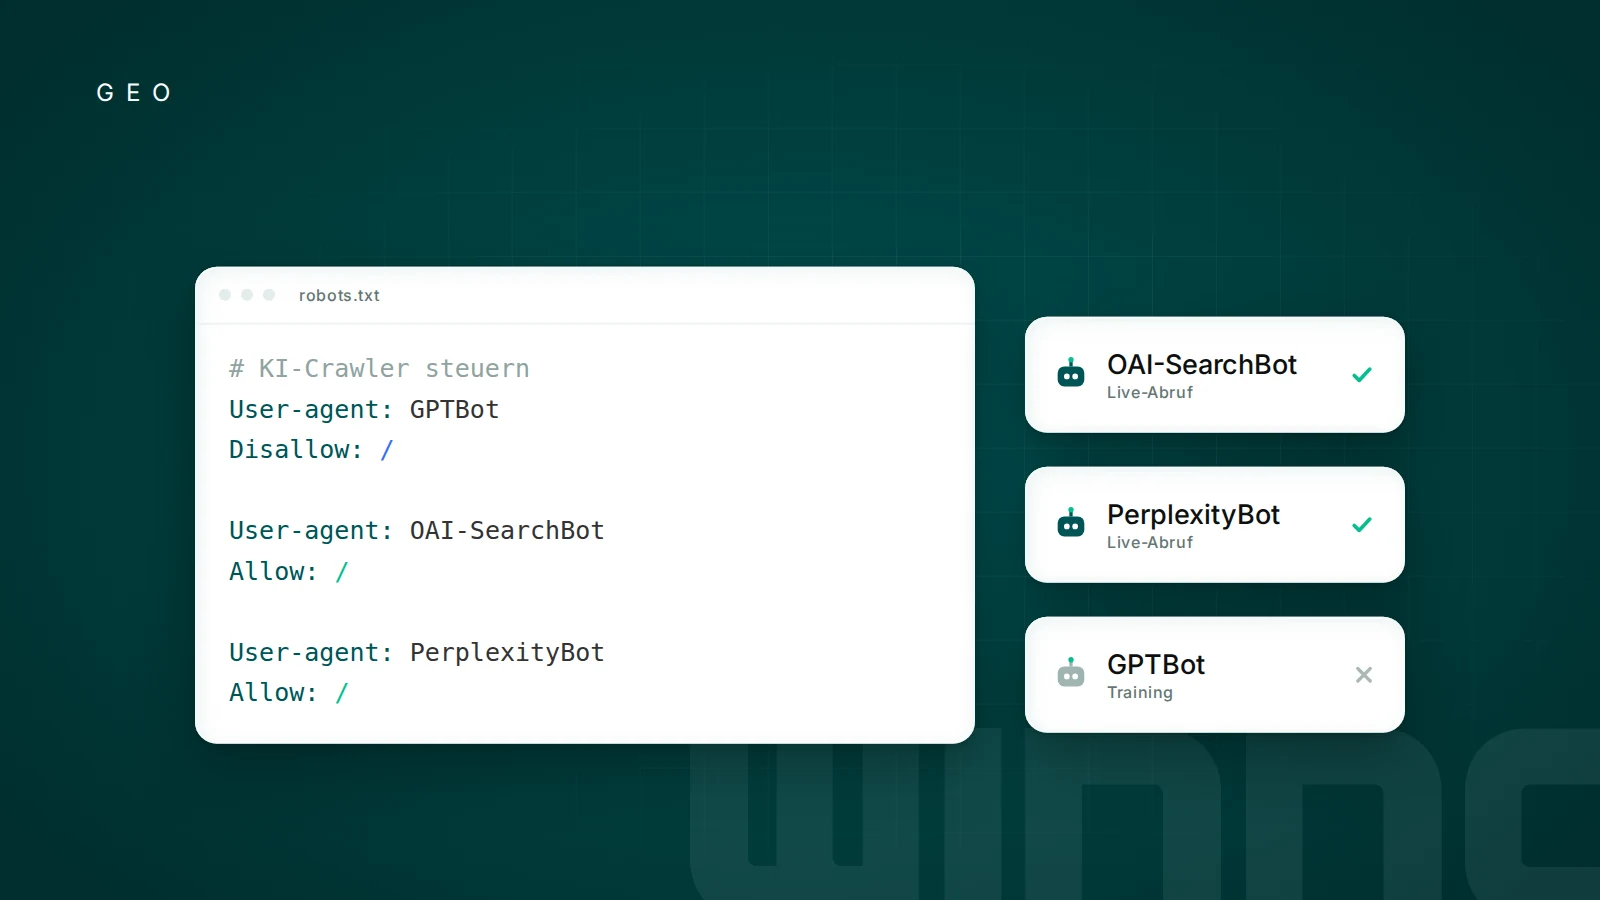
| GPTBot | OpenAI | Sammelt Webinhalte, die zum Training der Modelle verwendet werden können. | Sperren, wenn du kein Trainingsmaterial liefern willst. Deine Sichtbarkeit in ChatGPT hängt nicht daran. |
| OAI-SearchBot | OpenAI | Indexiert Seiten für die Suchfunktion von ChatGPT, damit sie dort als Quelle verlinkt werden können. | Erlauben, wenn du in ChatGPT-Antworten auftauchen willst. |
| ChatGPT-User | OpenAI | Holt einzelne Seiten in dem Moment, in dem eine Nutzerfrage oder eine Aktion in ChatGPT das auslöst. | Erlauben. Ohne Zugriff bleibt deine Seite im laufenden Gespräch ungelesen. |
| Google-Extended | Kein eigener Crawler, sondern ein Steuerungstoken. Es regelt, ob bereits geholte Inhalte für Gemini-Apps und die generativen APIs von Google verwendet werden. | Entscheidungssache. Google dokumentiert, dass ein Disallow hier weder Aufnahme noch Ranking in der Google Suche berührt. | |
| Googlebot | Crawlt für den Suchindex. Aus diesem Index speisen sich auch AI Overviews und der AI Mode. | Erlauben. Ein Ausschluss nimmt dich aus der Google Suche und damit auch aus deren KI-Antworten. | |
| PerplexityBot | Perplexity | Indexiert Seiten, damit sie in Perplexity-Antworten als Quelle verlinkt werden können. | Erlauben, wenn du dort als Quelle erscheinen willst. |
| ClaudeBot | Anthropic | Sammelt Webinhalte, die zum Training der Claude-Modelle verwendet werden können. | Sperren, wenn du kein Trainingsmaterial liefern willst. Für Suche und Nutzerabrufe dokumentiert Anthropic eigene Agenten. |
| Bingbot | Microsoft | Crawlt für den Bing-Index. Copilot greift auf diesen Index zu. | Erlauben. Eine Sperre trifft Bing und Copilot gleichzeitig. |
| Applebot-Extended | Apple | Kein eigener Crawler, sondern ein Steuerungstoken für die von Applebot geholten Inhalte. Es regelt deren Verwendung im Training der Apple-Modelle. | Entscheidungssache. Die Aufnahme in Apples Suchfunktionen bleibt davon unberührt. |
Zwei Einträge sind Sonderfälle. Google-Extended und Applebot-Extended holen selbst keine Seiten ab. Sie sind reine Steuerungstoken: Du schreibst sie in die robots.txt, und der Anbieter wertet das als Widerspruch gegen eine bestimmte Verwendung der Inhalte, die sein normaler Crawler ohnehin geholt hat.
Das erklärt eine Eigenheit. Ein Allow für diese beiden Token ergibt keinen Sinn. Sie kennen nur den Fall, dass du widersprichst.
Auffallend ist auch, wie unterschiedlich fein die Anbieter trennen. OpenAI dokumentiert drei getrennte Namen für drei Zwecke. Bei Google und Microsoft läuft das Crawlen für die KI-Antworten über denselben Bot wie die klassische Suche.
Die robots.txt richtig schreiben
Die Datei liegt im Wurzelverzeichnis deiner Domain, also unter /robots.txt. Sie gilt genau für diesen Host und dieses Protokoll. Eine Subdomain braucht ihre eigene.
Aufgebaut ist sie aus Gruppen. Eine Gruppe beginnt mit einer oder mehreren User-agent-Zeilen und enthält danach die Regeln Disallow und Allow. Ein leeres Disallow: bedeutet: nichts gesperrt.
Ein Detail wird ständig übersehen und kostet Sichtbarkeit. Ein Crawler befolgt genau eine Gruppe. Findet er eine Gruppe mit seinem eigenen Namen, ignoriert er die Sammelgruppe mit dem Stern vollständig. Deine allgemeinen Regeln gelten für ihn dann nicht mehr. Wer für GPTBot eine eigene Gruppe anlegt, muss dort alles wiederholen, was auch für GPTBot gelten soll.
Variante 1: alles erlauben
Der Normalfall für fast jede Dienstleisterseite. Jeder darf lesen, der Sitemap-Verweis hilft beim Finden.
User-agent: *
Disallow:
Sitemap: https://deine-domain.ch/sitemap.xml
Diese Zeilen sind keine Nachlässigkeit, sondern eine Entscheidung. Sie sagen: Meine Inhalte sollen gefunden werden, in der Suche und in KI-Antworten.
Variante 2: Training sperren, Live-Abruf erlauben
Die Variante für alle, die im Modelltraining nicht vorkommen wollen, in Antworten mit Quellenangabe aber schon.
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: Google-Extended
Disallow: /
User-agent: Applebot-Extended
Disallow: /
User-agent: *
Disallow:
Sitemap: https://deine-domain.ch/sitemap.xml
OAI-SearchBot, ChatGPT-User, PerplexityBot, Googlebot und Bingbot haben hier keine eigene Gruppe. Sie fallen in die Sammelgruppe am Ende und dürfen weiterhin alles lesen. Genau so ist es gemeint.
Variante 3: alles sperren
Die harte Variante. Sie richtet sich an jeden Crawler, der die Datei liest.
User-agent: *
Disallow: /
Sei dir im Klaren, was das heisst. Es trifft Googlebot und Bingbot genauso wie GPTBot. Deine Seiten verschwinden aus der Google Suche, aus Bing, aus den AI Overviews und aus jeder KI-Antwort, die eine Suche auslöst.
Und wegen der Gruppenregel von oben gilt: Sobald ein einzelner Bot eine eigene Gruppe bekommt, ist er von dieser Sperre ausgenommen. Wer alles ausser der klassischen Suche sperren will, muss jeden KI-Agenten einzeln aufführen, statt sich auf den Stern zu verlassen.
Ein Hinweis noch: Die robots.txt regelt den Abruf, nicht die Anzeige in der Suche. Ist eine URL trotz Sperre bekannt, kann sie weiterhin ohne Textauszug gelistet werden. Für das saubere Entfernen aus dem Index brauchst du ein noindex im Seitenkopf. Und damit dieses gelesen wird, darf die Seite nicht gleichzeitig gesperrt sein. Mehr zu diesem Zusammenspiel steht im Beitrag zum technischen SEO.
Die Abwägung
Es gibt hier keine Antwort, die für alle stimmt. Es gibt zwei Argumente, und beide sind ernst zu nehmen.
Für das Sperren spricht die Kontrolle. Deine Texte sind Arbeit. Du hast sie nicht geschrieben, damit ein Unternehmen daraus ein Produkt baut, an dem du nicht beteiligt bist. Dieses Unbehagen ist kein Missverständnis, sondern eine legitime Position.
Für das Erlauben spricht die Sichtbarkeit. Sie folgt einer schlichten Mechanik: Was nicht gelesen werden darf, kann nicht zitiert werden. Kein System empfiehlt eine Seite, die es nicht öffnen konnte. Was daraus praktisch folgt, zeigt unser Beitrag dazu, wie du in ChatGPT gefunden wirst.
Für Dienstleister, Handwerksbetriebe, Praxen und die meisten KMU fällt diese Rechnung klar aus. Deine Website ist kein Produkt, sie ist ein Schaufenster. Ihr Zweck ist, gefunden zu werden. Eine Sperre kostet dich Anfragen und bringt dir nichts zurück, das du verkaufen könntest.
Anders liegt der Fall bei Verlagen, Fachmedien, Datenbanken und allen, deren Inhalte selbst die Ware sind. Wer für Texte Geld verlangt, hat ein Interesse daran, sie nicht unentgeltlich ins Training zu geben. Hier kann die Sperre des Trainingszugriffs bei offenem Suchzugriff der richtige Mittelweg sein.
Ein Zwischenweg ist auch die Teilsperre. Du kannst einzelne Verzeichnisse ausnehmen, etwa ein Archiv oder einen Kursbereich, und den Rest offen lassen.
User-agent: GPTBot
Disallow: /archiv/
Disallow: /kurse/
Was diese Entscheidung nicht ersetzt, ist die inhaltliche Arbeit. Zugriff ist die Bedingung für Sichtbarkeit, nicht ihr Grund. Worauf es danach ankommt, steht im Beitrag zur Generative Engine Optimization.
Was die robots.txt nicht kann
Die robots.txt ist eine Bitte. Mehr nicht.
Sie ist eine Textdatei, die jeder abrufen kann. Ob ein Programm sich daran hält, entscheidet allein das Programm. Die grossen Anbieter tun es und dokumentieren das auch. Ein beliebiges Skript, das deine Seite abgreift, tut es nicht.
Dazu kommt: Ein User-Agent ist nur ein frei wählbarer Text im Anfragekopf. Er lässt sich fälschen. Wer prüfen will, ob ein Abruf echt war, gleicht die IP-Adresse gegen die vom Anbieter veröffentlichten Bereiche ab oder macht eine umgekehrte DNS-Auflösung. Google, OpenAI und Anthropic veröffentlichen dafür Listen ihrer IP-Bereiche.
Wenn du Inhalte wirklich schützen musst, brauchst du eine Sperre auf Serverebene. Also eine Regel in der Serverkonfiguration, in der Firewall oder beim CDN, die die Anfrage mit einem Statuscode abweist, bevor eine Zeile Text das Haus verlässt. Ein Login davor wirkt noch zuverlässiger: Was hinter einer Anmeldung liegt, holt kein Crawler.
Und ein letzter Punkt, der gerne untergeht. Eine Sperre bei dir hindert niemanden daran, über dich zu schreiben. Wird dein Text anderswo wiedergegeben, steht er dort, und dort wird er gelesen. Die robots.txt kontrolliert deine Domain, nicht das Netz.
Eine Ergänzung, keine Alternative, ist die llms.txt. Sie sperrt nichts, sondern schlägt vor, welche Seiten die wichtigsten sind. Verbindlich ist auch sie nicht.
Umsetzung in Webflow
In Webflow pflegst du die Datei nicht per FTP, sondern im Projekt. Du findest das Feld in den Site settings im Bereich SEO unter robots.txt. Dort trägst du ein, was du oben zusammengestellt hast.
Drei Punkte, an denen es in der Praxis hängt.
- Veröffentlichen nicht vergessen. Änderungen an der robots.txt werden erst mit dem nächsten Publish live. Solange steht die alte Fassung online.
- Auf den richtigen Host schauen. Die Datei gilt pro Host. Die Adresse auf webflow.io und deine eigene Domain sind getrennte Häuser. Prüfe nach dem Veröffentlichen die Live-Domain.
- Nach dem Publish nachlesen. Ruf deine-domain.ch/robots.txt im Browser auf und lies, was wirklich dort steht. Das ist die einzige Kontrolle, die zählt.
Weitere technische Einstellungen, die in Webflow gerne liegen bleiben, haben wir im Webflow SEO Guide gesammelt. Wenn du die Einrichtung lieber abgibst, übernimmt das unsere Webflow Agentur.
Was du jetzt tun solltest
Ruf deine eigene robots.txt auf und lies sie Zeile für Zeile. In vielen Fällen steht dort etwas, das niemand bewusst entschieden hat.
Dann triff die Entscheidung in zwei Schritten. Erstens: Willst du Trainingsmaterial liefern? Zweitens, und davon unabhängig: Willst du in Antworten zitiert werden?
Bei den meisten lautet die Antwort nein und ja. Genau dafür ist Variante 2 gebaut.
Passend dazu
- Generative Engine Optimization: was dahintersteckt
- In ChatGPT gefunden werden
- llms.txt: sinnvoll oder überschätzt?
- Technisches SEO: die Grundlagen
Du bist unsicher, was deine robots.txt gerade zulässt und was sie sperrt? Wir schauen sie uns an und sagen dir, welche Zeile welche Folge hat. Schreib uns über das Kontaktformular.