Lesezeit: ca. 10 Minuten | Niveau: Einsteiger bis Fortgeschrittene
Seit KI-Systeme Websites lesen, gibt es einen neuen Vorschlag: eine Datei namens llms.txt, die im Wurzelverzeichnis einer Website liegt und Sprachmodellen eine kurze, saubere Übersicht der wichtigsten Inhalte anbietet.
Der Vorschlag stammt von Jeremy Howard. Dokumentiert ist er unter llmstxt.org.
Die Idee dahinter ist einfach. Ein Sprachmodell hat ein begrenztes Kontextfenster. Es kann nicht beliebig viel Text gleichzeitig verarbeiten.
Eine normale HTML-Seite besteht aber nur zu einem kleinen Teil aus dem eigentlichen Inhalt. Der Rest sind Navigation, Skripte, Cookie-Banner, Footer, Werbeflächen und Layout-Markup. Wer diesen Ballast in ein Modell kippt, verbraucht Platz, ohne Information zu liefern.
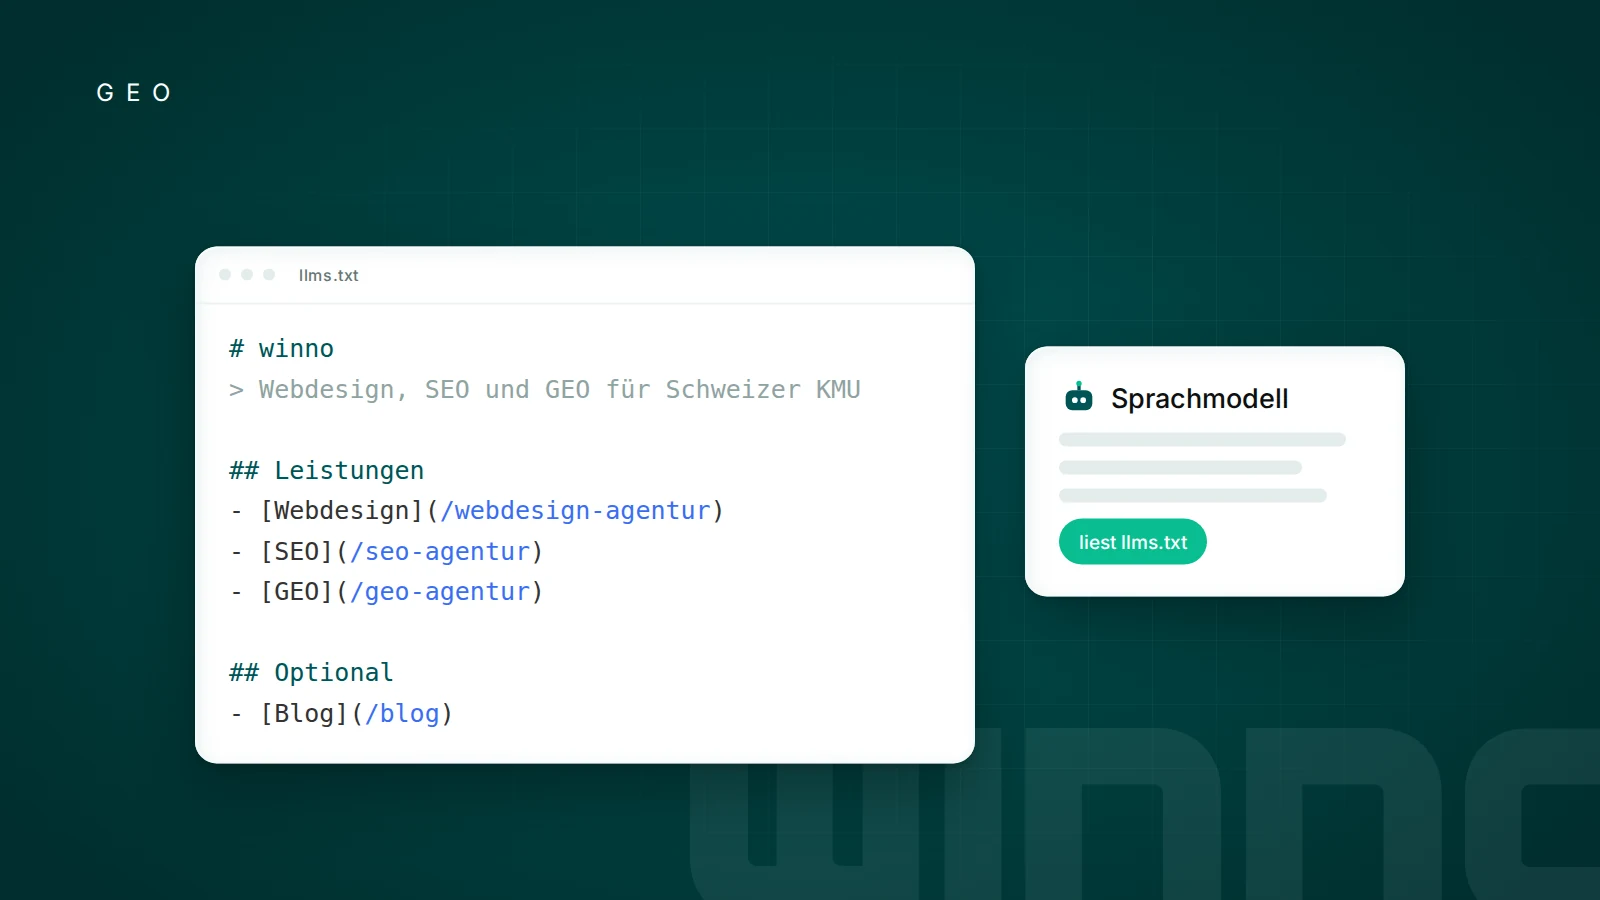
llms.txt dreht das um. Statt das Modell den Rohtext der Website auseinandernehmen zu lassen, legst du selbst eine kuratierte Markdown-Datei ab: eine Zusammenfassung, was diese Website ist, und eine Liste der Seiten, die wirklich zählen, jeweils mit einem Satz Erklärung.
Markdown deshalb, weil es für Menschen lesbar ist und für Maschinen eindeutig. Überschriften sind Überschriften, Links sind Links, sonst ist da nichts.
Der Rest dieses Artikels zeigt dir den Aufbau, ein Beispiel zum Kopieren, und danach die unbequeme Frage: ob deine Website das überhaupt braucht.
llms.txt, robots.txt und sitemap.xml sind drei verschiedene Dinge
Diese drei Dateien werden dauernd verwechselt. Sie liegen alle im Wurzelverzeichnis, sie heissen alle ähnlich technisch, und sie machen etwas völlig anderes.
robots.txt steuert Zugriff. Dort steht, welcher Bot welche Pfade abrufen darf und welche nicht. Es ist eine Anweisung an den Crawler, keine Inhaltsangabe. Wenn du steuern willst, ob GPTBot, ClaudeBot oder PerplexityBot auf deine Seiten dürfen, ist das der Ort dafür. Wie das konkret geht und welche Bots es überhaupt gibt, steht in unserem Beitrag zu KI-Crawlern und GPTBot.
sitemap.xml listet URLs. Sie sagt einem Crawler, welche Adressen es gibt und wann sie zuletzt geändert wurden. Sie enthält keinen Inhalt, keine Beschreibung, keine Gewichtung im inhaltlichen Sinn. Sie ist ein Inhaltsverzeichnis ohne Text. Warum sie trotzdem zur Pflichtausstattung gehört, behandelt unser Beitrag zu technischem SEO.
llms.txt bietet aufbereiteten Inhalt an. Sie sagt weder, wer rein darf, noch nur, welche URLs existieren. Sie erklärt in Prosa, worum es auf dieser Website geht, und führt die wichtigen Seiten mit einer kurzen Beschreibung auf. Sie ist zum Lesen gedacht, nicht zum Abarbeiten.
Kurz: robots.txt ist die Türpolitik, sitemap.xml ist das Inhaltsverzeichnis, llms.txt ist der Klappentext mit Leseempfehlung.
Wichtig ist noch etwas: llms.txt ersetzt keine der beiden anderen Dateien. Sie kommt dazu oder sie kommt nicht. Wer seine sitemap.xml weglässt, weil er jetzt eine llms.txt hat, hat den Punkt verpasst.
Wie eine llms.txt aufgebaut ist
Das unter llmstxt.org dokumentierte Format ist bewusst schlank. Es besteht aus fünf Bauteilen, von denen zwei Pflicht sind.
1. Eine H1 mit dem Namen des Projekts. Genau eine, ganz oben, mit einem einzelnen Rautezeichen. Das ist der einzige wirklich verpflichtende Teil. Hier steht der Name der Website oder des Unternehmens, sonst nichts.
2. Ein Blockquote mit einer kurzen Zusammenfassung. Eine Zeile, die mit einem Grösser-Zeichen beginnt. Zwei bis drei Sätze, die erklären, worum es geht. Wer das liest und danach nicht weiss, was diese Website ist, hat den Absatz falsch geschrieben.
3. Optionale Fliesstextabschnitte. Danach darf normaler Markdown-Text folgen: Details, Einordnung, Hinweise, was jemand wissen sollte, bevor er die verlinkten Seiten öffnet. Nur keine Überschriften, denn die leiten schon den nächsten Teil ein.
4. H2-Abschnitte mit Linklisten. Jeder Abschnitt hat eine Überschrift mit zwei Rautezeichen und darunter eine Liste. Jeder Listenpunkt ist ein Markdown-Link, gefolgt von einem Doppelpunkt und einer kurzen Beschreibung. Genau diese Beschreibung ist der eigentliche Wert der Datei: Sie sagt einem Modell, was es auf der Seite erwartet, bevor es sie abruft.
5. Ein Abschnitt "Optional". Ein H2 mit genau diesem Namen hat im Format eine besondere Bedeutung. Alles darunter gilt als verzichtbar. Wenn der Platz knapp wird, darf ein System diesen Teil weglassen, ohne dass etwas Wichtiges fehlt. Dort gehören Dinge hin wie das Blog-Archiv, offene Stellen oder das Impressum.
Die Datei heisst llms.txt und liegt im Wurzelverzeichnis, also unter deinedomain.ch/llms.txt. Der Inhalt ist Markdown, obwohl die Endung .txt lautet. Das ist kein Widerspruch, sondern Absicht: Sie soll sich überall öffnen lassen.
Halte sie kurz. Eine llms.txt mit zweihundert Links ist keine Kuration mehr, sondern eine zweite Sitemap. Zwanzig gut ausgewählte Einträge sagen mehr als zweihundert vollständige.
Ein vollständiges Beispiel zum Kopieren
Das Folgende ist ein erfundenes Beispiel für eine fiktive Schweizer Firma. Die Firma, die Adresse und die Links gibt es nicht. Nimm die Struktur, ersetze den Inhalt.
Beispiel Anfang
- # Furrer Elektro AG
- > Elektroinstallationen für Wohn- und Gewerbebauten in Winterthur und Umgebung. Familienbetrieb, gegründet 1998. Schwerpunkte: Sanierung im bewohnten Bestand, Ladeinfrastruktur und Photovoltaik-Anschlüsse.
- Wir arbeiten im Kanton Zürich und in angrenzenden Gemeinden. Anfragen laufen über das Kontaktformular oder telefonisch. Offerten erstellen wir nach einem Termin vor Ort, Richtpreise nennen wir vorher. Alle Preise verstehen sich zuzüglich Mehrwertsteuer.
- ## Leistungen
- - [Elektroinstallation](https://furrer-elektro.ch/elektroinstallation.md): Neubau und Sanierung, von der Planung über die Ausführung bis zur Schlusskontrolle.
- - [Ladestationen](https://furrer-elektro.ch/ladestationen.md): Wallboxen für Einfamilienhäuser und Tiefgaragen, inklusive Lastmanagement und Anmeldung beim Netzbetreiber.
- - [Photovoltaik-Anschluss](https://furrer-elektro.ch/photovoltaik.md): Elektrischer Anschluss von PV-Anlagen, Messkonzept und Abnahme.
- - [Störungsdienst](https://furrer-elektro.ch/stoerungsdienst.md): Erreichbarkeit, Reaktionszeiten und Ablauf bei Ausfällen.
- ## Über die Firma
- - [Team](https://furrer-elektro.ch/team.md): Wer bei uns arbeitet, mit Ausbildung und Zuständigkeit.
- - [Referenzen](https://furrer-elektro.ch/referenzen.md): Ausgeführte Projekte mit Umfang, Dauer und Ansprechperson.
- - [Kontakt](https://furrer-elektro.ch/kontakt.md): Adresse, Öffnungszeiten, Anfahrt und Formular.
- ## Optional
- - [Ratgeber](https://furrer-elektro.ch/ratgeber.md): Beiträge zu Normen, Förderbeiträgen und Abläufen.
- - [Offene Stellen](https://furrer-elektro.ch/jobs.md): Aktuelle Vakanzen und Lehrstellen.
Beispiel Ende
Drei Dinge an diesem Beispiel sind bewusst so gemacht.
Die Beschreibungen nach dem Doppelpunkt sind konkret. "Wallboxen für Einfamilienhäuser und Tiefgaragen" sagt etwas. "Unser Angebot rund um Mobilität" sagt nichts.
Die Reihenfolge ist eine Aussage. Was zuerst steht, gilt als wichtiger. Wenn dein Kerngeschäft unter "Optional" landet, stimmt etwas nicht.
Und die Links zeigen auf .md-Adressen. Warum, steht im nächsten Abschnitt.
Die Ergänzung: einzelne Seiten zusätzlich als Markdown
Zum Vorschlag gehört eine zweite Konvention. Sie ist optional, aber sie macht die erste erst richtig nützlich.
Die Idee: Du stellst jede wichtige Seite zusätzlich als reine Markdown-Version bereit, unter derselben URL mit angehängtem .md.
Aus deinedomain.ch/leistungen wird also zusätzlich deinedomain.ch/leistungen.md. Gleiche Seite, gleicher Inhalt, nur ohne Navigation, ohne Skripte, ohne Banner. Nur Überschriften, Text, Listen und Links.
Der Mechanismus dahinter ist der eigentliche Punkt. Ein System, das deine llms.txt liest, findet dort Links. Folgt es einem davon und bekommt sauberes Markdown zurück, muss es nichts mehr herausfiltern. Es kann den Text direkt verwenden.
Bekommt es stattdessen eine normale HTML-Seite, muss es erst den Inhalt vom Rest trennen. Das geht meistens, aber es geht nicht immer sauber. Genau an dieser Stelle verschwinden Inhalte, die eigentlich da waren. Wie Systeme abgerufene Seiten weiterverarbeiten, beschreibt unser Beitrag zu RAG und Grounding in der KI-Suche.
Technisch ist das eine zusätzliche Ausgabe derselben Inhalte. Bei einem System, das die Inhalte ohnehin strukturiert verwaltet, ist das oft eine Frage der Vorlage. Bei einer handgepflegten Website bedeutet es doppelte Arbeit bei jeder Änderung.
Wenn du dich für die .md-Variante entscheidest, mach es automatisch oder gar nicht. Von Hand gepflegte Zweitversionen laufen nach wenigen Monaten auseinander.
Braucht deine Website das?
Jetzt der Teil, den du in den meisten Artikeln zu diesem Thema nicht findest.
llms.txt ist ein Vorschlag, kein übernommener Standard. Die Datei ist unter llmstxt.org sauber dokumentiert, sie hat eine klare Spezifikation, und sie wird von einigen Tools und Dokumentationsseiten verwendet. Aber sie wurde von keinem der grossen Anbieter offiziell als Standard übernommen.
Es gibt keine Bestätigung, dass die grossen Anbieter die Datei auswerten. Weder Google noch OpenAI noch Anthropic haben dokumentiert, dass ihre Systeme eine llms.txt lesen oder bevorzugt verwenden. Das ist kein Gerücht und keine Verschwörung, sondern schlicht der Stand der öffentlichen Dokumentation.
Alles, was du im Netz an Gegenteiligem liest, ist bis auf Weiteres Vermutung. Wenn jemand behauptet, ein bestimmter Anbieter lese die Datei nachweislich, dann frag nach der Quelle. Meistens gibt es keine.
Der Aufwand ist klein, der nachweisbare Nutzen ist offen. Eine gute llms.txt für eine mittelgrosse Firmenwebsite schreibst du in einer bis zwei Stunden. Das ist wenig. Was sie bringt, weiss aktuell niemand belastbar.
Daraus folgt eine nüchterne Empfehlung.
Mach es, wenn deine Website ohnehin gepflegt wird, der Aufwand klein bleibt und du die Datei bei Änderungen mitziehst. Der Nebeneffekt ist real: Wer eine llms.txt schreibt, muss entscheiden, welche zwanzig Seiten wirklich zählen. Diese Übung ist auch ohne KI wertvoll.
Mach es nicht, wenn du sie als Ersatz für saubere HTML-Struktur verstehst. Eine llms.txt repariert keine kaputte Seitenstruktur, keine fehlenden Überschriften und keine Inhalte, die hinter JavaScript verschwinden. Diese Arbeit wird von jedem System gelesen, die llms.txt vielleicht von keinem.
Erwarte keine messbaren Effekte. Es gibt keinen Weg, einen Anstieg der Sichtbarkeit sauber auf diese Datei zurückzuführen. Wer dir das verspricht, misst etwas anderes. Welche Kennzahlen bei KI-Sichtbarkeit überhaupt etwas aussagen, steht in unserem Beitrag zu KI-Sichtbarkeit messen.
Die Reihenfolge der Arbeit ist damit klar. Zuerst Struktur, Zugänglichkeit und klare Inhalte. Dann Schema Markup für die KI-Suche, weil das von Suchmaschinen dokumentiert ausgewertet wird. Und dann, wenn noch Zeit bleibt, die llms.txt. Den Gesamtrahmen dazu beschreibt unser Beitrag zu Generative Engine Optimization.
Die drei Dateien im Vergleich
| Datei | Zweck | Wer sie liest | Ist sie ein offizieller Standard |
|---|---|---|---|
| robots.txt | Steuert, welche Bots welche Pfade abrufen dürfen | Suchmaschinen-Crawler und KI-Crawler, die sich daran halten | Ja, als RFC 9309 festgehalten und von den grossen Anbietern dokumentiert unterstützt |
| sitemap.xml | Listet die URLs einer Website samt Änderungsdatum | Suchmaschinen-Crawler | Ja, das Sitemap-Protokoll ist offen dokumentiert und wird von Google und Bing unterstützt |
| llms.txt | Bietet eine kuratierte Markdown-Übersicht der wichtigsten Inhalte zum Lesen an | Einzelne Tools und Anwendungen, die den Vorschlag umsetzen | Nein, ein dokumentierter Vorschlag unter llmstxt.org ohne offizielle Übernahme durch die grossen Anbieter |
Pflege: eine veraltete llms.txt ist schlechter als keine
Das ist der Punkt, an dem die meisten Umsetzungen scheitern. Nicht beim Schreiben, sondern sechs Monate danach.
Der Grund liegt im Charakter der Datei. Eine sitemap.xml, die eine gelöschte URL enthält, produziert einen Fehler beim Abruf. Das fällt auf und wird korrigiert.
Eine llms.txt produziert keinen Fehler. Sie behauptet weiter, dass du eine Leistung anbietest, die du eingestellt hast. Sie nennt weiter einen Standort, den du aufgegeben hast. Und sie tut das in einem Format, das ausdrücklich als kuratierte Auswahl gekennzeichnet ist.
Genau darin liegt das Problem. Eine normale Seite, die veraltet ist, steht neben anderen Signalen und wird eingeordnet. Eine llms.txt sagt dem lesenden System: Das hier ist die von der Firma selbst zusammengestellte Wahrheit. Falsche Angaben bekommen dadurch mehr Gewicht, nicht weniger.
Drei einfache Regeln halten das im Griff.
- Halte sie kurz. Je weniger drinsteht, desto weniger kann veralten. Nimm nur Seiten auf, die es in zwei Jahren noch gibt.
- Koppele sie an einen bestehenden Ablauf. Jedes Mal, wenn eine Leistungsseite entsteht oder verschwindet, wird die Datei mitgezogen. Nicht "wenn wir Zeit haben".
- Setz dir einen festen Termin. Zweimal im Jahr durchlesen, Links prüfen, Beschreibungen gegen die Realität halten. Das dauert zwanzig Minuten.
Wenn du weisst, dass keine dieser drei Regeln bei dir eingehalten wird, dann lass die Datei weg. Das ist die bessere Entscheidung.
llms.txt in Webflow bereitstellen
Webflow hat eigene Felder für robots.txt und erzeugt die sitemap.xml selbst. Ein eigenes Feld für eine llms.txt gibt es zum Zeitpunkt dieses Artikels nicht.
Es bleiben zwei praktikable Wege.
Weg eins: eine eigene Seite. Du legst eine statische Seite an, zum Beispiel unter /llms-txt, und schreibst den Inhalt dort in ein einzelnes Textelement. Danach richtest du in den Site-Einstellungen eine Weiterleitung von /llms.txt auf diese Seite ein.
Der Haken daran: Die Seite wird als HTML ausgeliefert, nicht als reiner Text. Der Inhalt ist lesbar, aber die Datei ist streng genommen keine .txt-Datei. Ob das für ein lesendes System ein Problem ist, lässt sich nicht seriös sagen.
Weg zwei: vor die Website schalten. Wenn deine Domain über einen Dienst läuft, der Anfragen abfangen kann, lässt sich /llms.txt dort direkt als Textdatei ausliefern. Das ist technisch sauberer und aufwendiger.
Für die meisten KMU-Websites reicht Weg eins. Er kostet eine halbe Stunde, und er lässt sich jederzeit ersetzen.
Wichtiger als die Datei selbst bleibt in Webflow die Grundausstattung: saubere Überschriftenstruktur, sprechende URLs, gepflegte Meta-Angaben, schnelle Seiten. Was dazugehört, steht im Webflow SEO Guide 2026.
Und wenn du das lieber jemandem übergibst, der täglich in Webflow arbeitet: Genau das machen wir als Webflow Agentur.
Kurz zusammengefasst
llms.txt ist eine kuratierte Markdown-Übersicht deiner Website, die im Wurzelverzeichnis liegt und Sprachmodellen Arbeit abnimmt.
Sie ersetzt weder robots.txt noch sitemap.xml, sondern kommt daneben.
Der Aufbau ist in einer halben Stunde verstanden: H1, Blockquote, optionaler Fliesstext, H2-Abschnitte mit beschriebenen Links, am Schluss ein Abschnitt "Optional".
Ob sie etwas bringt, ist offen. Kein grosser Anbieter hat bestätigt, dass er sie auswertet.
Mach sie trotzdem, wenn deine Website ohnehin gepflegt wird und du sie aktuell hältst. Lass sie weg, wenn sie zur Karteileiche wird oder wenn sie dich von der Grundarbeit abhält.
Passend dazu
- Generative Engine Optimization: der Überblick
- KI-Crawler wie GPTBot gezielt steuern
- Schema Markup für die KI-Suche
- Content so schreiben, dass KI-Systeme ihn verwenden
Du bist unsicher, ob sich der Aufwand bei deiner Website lohnt? Wir schauen uns Struktur, Crawling und Inhalte an und sagen dir, was zuerst dran ist. Melde dich über unser Kontaktformular.